Что такое Qwen-Image-2.1-Uncensored-GGUF
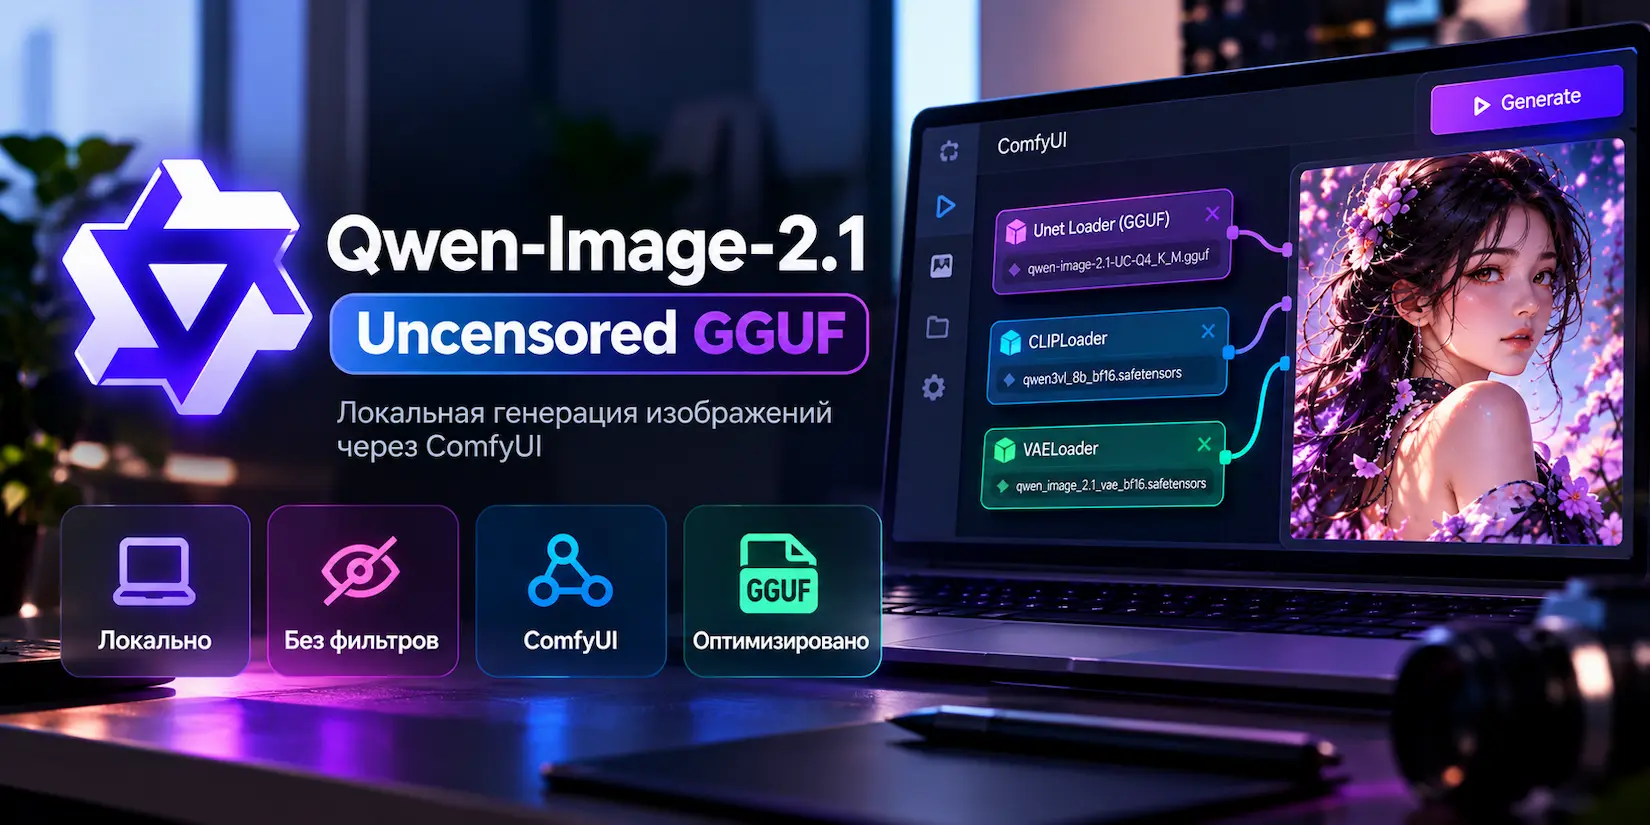
Qwen-Image-2.1-Uncensored-GGUF – это набор квантованных файлов модели Qwen-Image-2.1 для локальной генерации изображений через ComfyUI. Это не готовый онлайн-сервис с кнопкой «Создать», а репозиторий на Hugging Face: пользователю необходимо самостоятельно скачать файлы, установить нужные компоненты и настроить запуск на своём компьютере.
Сборка основана на исходных весах Qwen/Qwen-Image-2.1 и использует формат GGUF. Квантование позволяет уменьшить размер модели по сравнению с более тяжёлыми вариантами весов, поэтому локальный запуск может быть доступнее для части конфигураций.
Главная особенность релиза – отсутствие встроенного модуля проверки безопасности и фильтра контента. Модель способна обрабатывать взрослые, NSFW- и чувствительные запросы без автоматических отказов или подмены результата затемнённым изображением.
Проект ориентирован прежде всего на пользователей ComfyUI, разработчиков и энтузиастов локальных моделей. Он подойдёт тем, кто хочет самостоятельно выбирать модель, текстовый энкодер, VAE и параметры генерации. Новичкам без опыта работы с нодовым интерфейсом ComfyUI настройка может показаться заметно сложнее, чем использование облачных генераторов.
Ключевые возможности Qwen-Image-2.1-Uncensored-GGUF
Основная возможность сборки – локальный запуск Qwen-Image-2.1 в формате GGUF. Пользователь скачивает файл модели с расширением
.gguf
, размещает его в нужной папке ComfyUI и подключает через ноду загрузки модели. В репозитории рекомендуют вариант
qwen-image-2.1-UC-Q4_K_M.gguf
как компромисс между размером и качеством генерации.
Указанная конфигурация занимает около 4,6 ГБ видеопамяти, однако фактическое потребление ресурсов зависит не только от GGUF-файла. На него влияют разрешение изображения, параметры генерации, выбранный текстовый энкодер, VAE, объём VRAM и RAM, а также версия ComfyUI и установленных расширений.
Локальный формат будет полезен пользователям, которые не хотят отправлять промпты и результаты генерации в сторонние веб-интерфейсы.
Работа через ComfyUI и ComfyUI-GGUF
Модель подключается к ComfyUI через расширение ComfyUI-GGUF. В инструкции рекомендуется использовать форк
leejet/ComfyUI-GGUF
, в котором заявлена нативная поддержка Qwen-Image 2.1. Расширение необходимо установить в каталог
ComfyUI/custom_nodes
.
После установки в workflow добавляют ноду Unet Loader (GGUF) и выбирают в ней скачанный GGUF-файл. Одной диффузионной модели для полноценного запуска недостаточно: также понадобятся текстовый энкодер и VAE.
- Для загрузки модели используется нода Unet Loader (GGUF) .
-
Для текстового энкодера применяется стандартная нода
CLIPLoader
с файлом
qwen3vl_8b_bf16.safetensorsили версиейint8. -
В настройках CLIPLoader необходимо выбрать тип
qwen_image. -
Для VAE используется нода
VAELoader
и файл
qwen_image_2.1_vae_bf16.safetensors.
Все перечисленные компоненты доступны в том же репозитории. Если при использовании старой версии расширения
city96/ComfyUI-GGUF
появляется ошибка
Unknown model architecture!
, рекомендуется перейти на форк
leejet
либо вручную добавить
ModelQwenImage
в файл
tools/convert.py
.
Готовые workflow для генерации и редактирования
Для Qwen-Image-2.1 доступны официальные шаблоны Comfy-Org: Text-to-Image и Image Edit . Первый workflow предназначен для создания изображений по текстовому описанию, второй – для работы с готовыми изображениями.
В обоих шаблонах стандартную ноду
UNETLoader
необходимо заменить на
Unet Loader (GGUF)
. После этого можно подключить скачанный GGUF-файл, указать нужные компоненты, написать промпт и запустить генерацию.
Готовые workflow позволяют не собирать стартовый граф ComfyUI с нуля. Для сценария Image Edit потребуется соответствующий шаблон и исходное изображение, которое будет использоваться в процессе редактирования.
Настройка VRAM и оперативной памяти
Отдельно есть способ распределить нагрузку между видеопамятью и оперативной памятью. Диффузионную GGUF-модель рекомендуется оставлять в VRAM, поскольку она активно используется во время семплирования и непосредственно влияет на процесс генерации.
Текстовый энкодер можно разместить в оперативной памяти или выгружать в RAM. Он обрабатывает текст, как правило, один раз для каждого промпта, поэтому такой подход не будет существенно замедлять генерацию.
Перенос текстового энкодера из VRAM в RAM способен освободить примерно от 9 до 17 ГБ видеопамяти – точное значение зависит от выбранной версии энкодера и конфигурации системы.
Если ComfyUI сообщает о нехватке видеопамяти, автор предлагает запускать программу с аргументом
--lowvram
. Эта опция может помочь снизить нагрузку на VRAM, но не отменяет аппаратные требования и не гарантирует работу на любой системе.
Генерация без встроенного фильтра контента
В версии Qwen-Image-2.1-Uncensored-GGUF отсутствуют встроенные safety checker и фильтр контента. Модель не будет автоматически отказывать в обработке взрослых, NSFW- или чувствительных запросов и не будет заменять результат чёрным изображением из-за характера промпта.
Именно отсутствие такого фильтра отличает сборку от версий, в которых ограничения могут быть встроены в процесс генерации.
При локальном использовании ответственность за промпты, хранение результатов, маркировку материалов и соблюдение правил площадок остаётся на пользователе.
Условия использования и лицензия
Qwen-Image-2.1-Uncensored-GGUF доступен в рамках бесплатного проекта.
Проект распространяется с указанием лицензии Qwen Research License .
Часто задаваемые вопросы
Что такое Qwen-Image-2.1-Uncensored-GGUF?
Qwen-Image-2.1-Uncensored-GGUF – это набор квантованных файлов модели Qwen-Image-2.1 для локальной генерации изображений через ComfyUI. Это не облачный генератор с готовым веб-интерфейсом, а репозиторий на Hugging Face, компоненты которого нужно скачать и настроить на своём компьютере. Для запуска используются файлы формата GGUF, текстовый энкодер и VAE.
Для чего нужен Qwen-Image-2.1-Uncensored-GGUF?
Модель нужна для создания изображений по текстовым описаниям локально, без отправки промптов и результатов в сторонний веб-интерфейс. Также для неё доступны workflow для редактирования готовых картинок. Пользователь самостоятельно выбирает модель, текстовый энкодер, VAE и настройки графа в ComfyUI.
Кому подойдет Qwen-Image-2.1-Uncensored-GGUF?
Qwen-Image-2.1-Uncensored-GGUF подойдёт пользователям ComfyUI, разработчикам и энтузиастам локальных моделей, которые уже понимают основы установки нод и подключения весов. Он может быть удобен тем, кому важно самостоятельно контролировать локальную среду генерации. Новичкам без опыта работы с ComfyUI настройка может показаться сложнее, чем использование облачных сервисов.
Какие возможности Qwen-Image-2.1-Uncensored-GGUF заявлены в репозитории?
Основные возможности Qwen-Image-2.1-Uncensored-GGUF – локальная генерация изображений в формате GGUF, работа с workflow Text-to-Image и Image Edit, а также настройка распределения нагрузки между VRAM и оперативной памятью. Есть несколько квантованных вариантов модели, текстовые энкодеры и VAE. Для проверки загруженных файлов опубликованы контрольные суммы SHA256.
Как пользоваться Qwen-Image-2.1-Uncensored-GGUF?
Сначала нужно установить ComfyUI и расширение ComfyUI-GGUF, причём в инструкции рекомендован форк leejet/ComfyUI-GGUF с поддержкой Qwen-Image 2.1. Затем GGUF-файл подключают через ноду Unet Loader (GGUF), текстовый энкодер – через CLIPLoader с типом qwen_image , а VAE – через VAELoader. Для старта можно использовать официальный шаблон Text-to-Image или Image Edit, заменив в нём обычную ноду UNETLoader.
Какие файлы нужны для запуска модели в ComfyUI?
Одного файла GGUF недостаточно: дополнительно понадобятся текстовый энкодер и VAE из того же репозитория. Есть энкодеры qwen3vl_8b_bf16.safetensors или версия int8, а также VAE qwen_image_2.1_vae_bf16.safetensors . Для модели в качестве компромисса между размером и качеством рекомендуется вариант qwen-image-2.1-UC-Q4_K_M.gguf .
Есть ли у модели фильтр контента?
Встроенные safety checker и фильтр контента отсутствуют. Модель не будет автоматически отказываться от взрослых, NSFW- или чувствительных запросов и заменять результат чёрным изображением.
Сколько видеопамяти нужно для Qwen-Image-2.1-Uncensored-GGUF?
Рекомендуемый файл qwen-image-2.1-UC-Q4_K_M.gguf занимает около 4,6 ГБ VRAM. При нехватке видеопамяти текстовый энкодер можно перенести в оперативную память: в примере вариант int8 занимает около 9,35 ГБ RAM и способен освободить примерно от 9 до 17 ГБ VRAM в зависимости от конфигурации.
Что делать при ошибке Unknown model architecture в ComfyUI?
Такая ошибка может возникнуть при использовании старой версии расширения city96/ComfyUI-GGUF. Рекомендуется перейти на поддерживаемый форк leejet/ComfyUI-GGUF, где есть нативная поддержка Qwen-Image 2.1. Альтернативный вариант – вручную добавить ModelQwenImage в файл tools/convert.py .
Есть ли бесплатный тариф Qwen-Image-2.1-Uncensored-GGUF?
Qwen-Image-2.1-Uncensored-GGUF доступен в рамках бесплатного проекта.
Какие ограничения есть у Qwen-Image-2.1-Uncensored-GGUF?
Для работы потребуется самостоятельно установить и настроить ComfyUI, расширение, модель, энкодер и VAE. Производительность зависит от видеокарты, доступной VRAM, оперативной памяти, выбранной квантованной версии и параметров ComfyUI.
Чем Qwen-Image-2.1-Uncensored-GGUF отличается от обычных онлайн-генераторов?
Главное отличие – в этой сборке есть отсутствие встроенного фильтра контента, также локальный запуск через ComfyUI вместо готового облачного интерфейса. Пользователь сам скачивает компоненты, собирает или открывает workflow и управляет тем, как распределяется нагрузка между видеопамятью и RAM.