Что такое LFM3
LFM3 – семейство нейросетевых моделей Liquid AI с открытыми весами для работы с текстом, изображениями, аудио, видео и структурированными решениями. В первый релиз вошли шесть моделей класса около 2 млрд параметров: текстовая, визуальная, аудио, омнимодальная и две decision-модели.
Все модели построены на общей базовой LFM3-1.7B-Base и рассчитаны на локальный запуск, дообучение под конкретную задачу и развёртывание рядом с приложением. Вместо одной большой универсальной модели Liquid AI предлагает компактные варианты под разные типы входных данных: текст, изображение, звук или их сочетание.
Семейство основано на гибридной архитектуре, сочетающей короткие свёртки, sliding-window attention и глобальное attention. Базовая LFM3-1.7B предварительно обучалась на 22 трлн токенов, а текстовая версия получила контекстное окно до 256 тыс. токенов. Размер 4-битной версии текстовой модели составляет около 1 ГБ, что важно для устройств с ограниченной памятью.
LFM3 может пригодиться разработчикам локальных агентов, голосовых и мультимодальных приложений, а также командам, которым нужно адаптировать модель под узкую предметную область. Среди сценариев – обработка писем, работа с календарём, анализ документов и фото, голосовые команды, поддержка, промышленная инспекция и робототехника.
Это не готовый потребительский чат-бот, а линейка моделей и инструментов для встраивания в собственные продукты. Весовые коэффициенты базовых и постобученных моделей доступны на Hugging Face, в Playground и через Liquid AI API.
Текстовая модель LFM3-1.7B для локальных агентов
LFM3-1.7B – текстовая модель с контекстным окном до 256 тыс. токенов, подготовленная для работы в агентских окружениях. Liquid AI относит к совместимым инструментам Hermes Agent, Pi и OpenClaw. Модель умеет работать с вызовами инструментов, следовать инструкциям и обрабатывать длинный контекст.
Практический сценарий – автоматизация повторяющихся действий, когда агенту нужно не только сгенерировать текст, но и выбрать подходящий инструмент. Liquid AI может провести сортировку входящих писем, управлять календарём, провести поиск информации в интернете, утренних сводок в WhatsApp и выбору нужного инструмента среди множества вариантов.
Для подобных сценариев разработчику потребуется самостоятельно настроить агентское окружение, подключить внешние сервисы и определить правила доступа. Модель можно дообучить под собственные домены, инструменты и агентские обвязки на одной GPU.
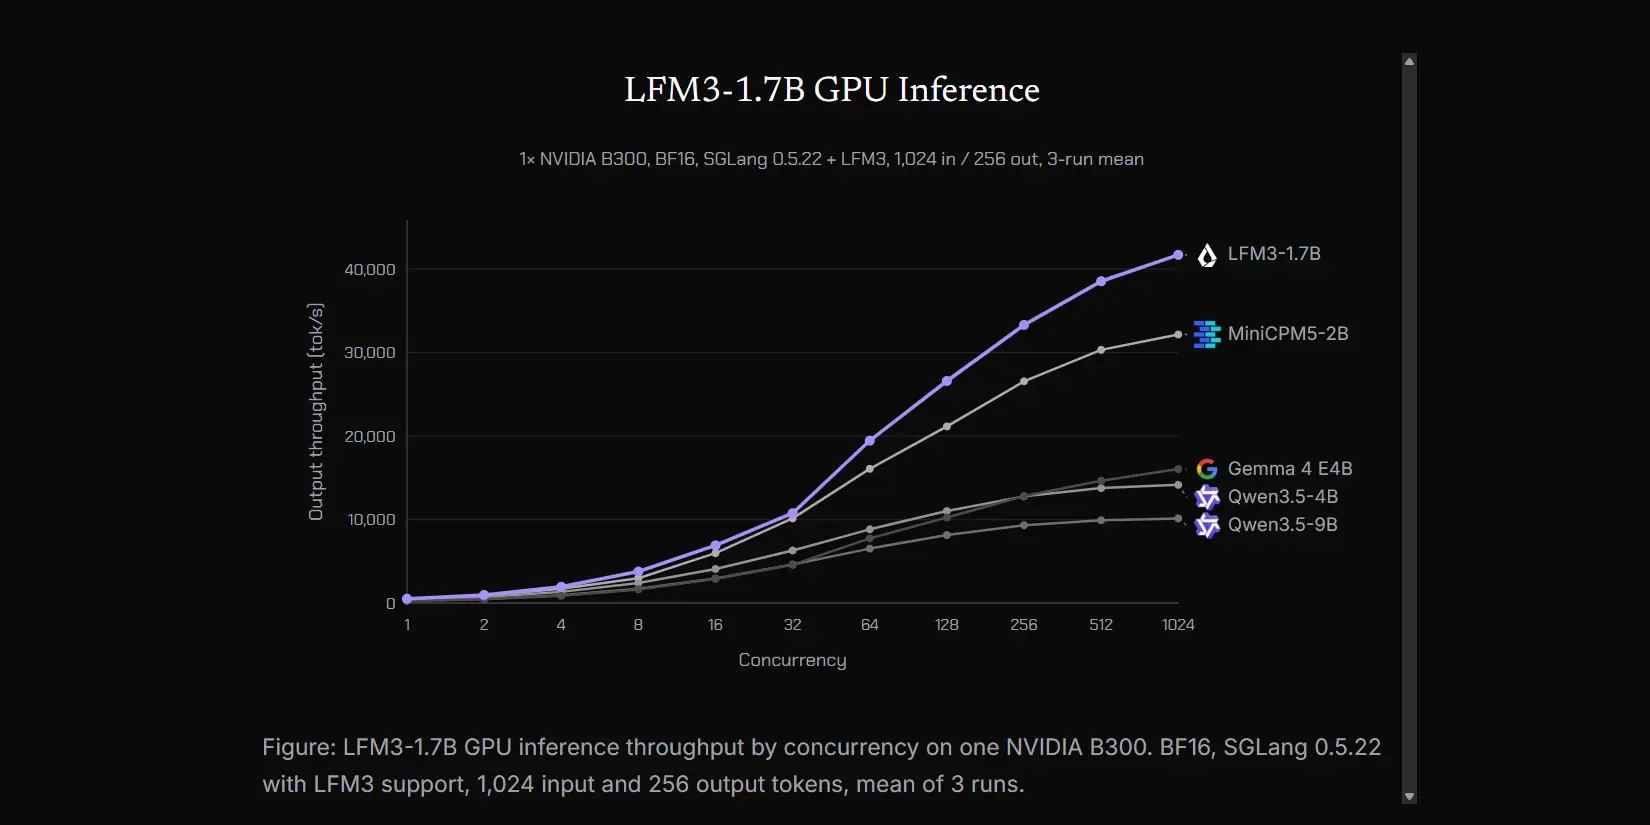
LFM3-1.7B сопоставима с LFM2-1.2B на коротких запросах на периферийных устройствах, а при контексте в 8 тыс. токенов примерно на 25% быстрее.
Обработка изображений и видео в LFM3-VL-2B
LFM3-VL-2B принимает визуальные данные и отвечает на вопросы о содержимом изображений и видео. Это первая визуальная модель Liquid AI с поддержкой видео на входе. Её можно использовать для разбора лекций, роликов с камер или видео, снятых на телефон.
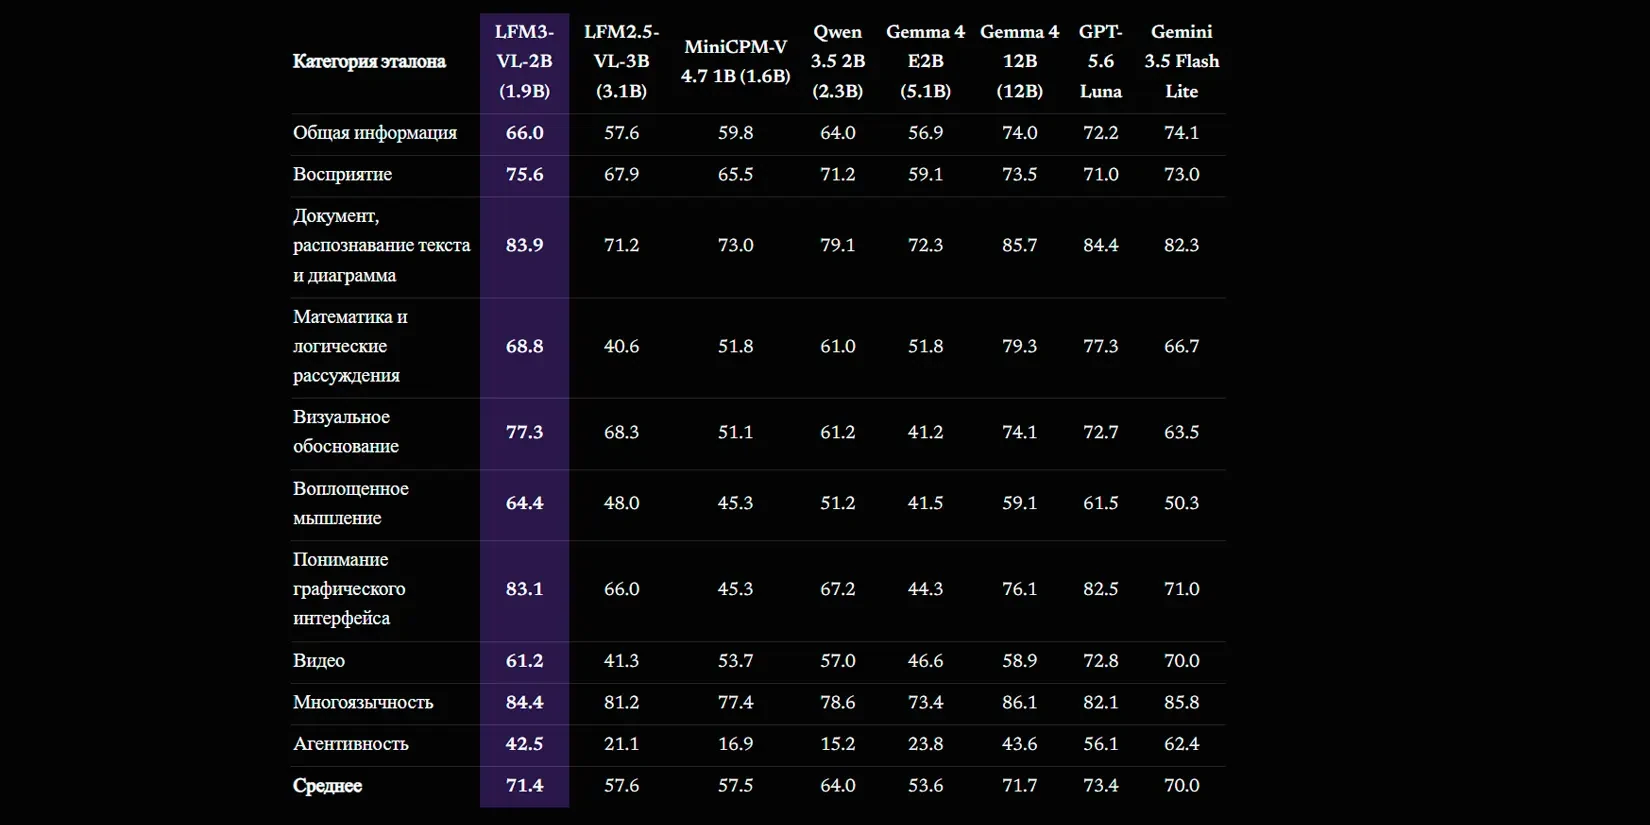
Модель рассчитана на задачи, где недостаточно просто распознать объект: ей нужно связать несколько деталей в сцене. Нейросеть способна провести анализ документов, OCR, диаграмм, математических задач, пространственных отношений и интерфейсов. Например, можно передать фотографию документа и спросить о конкретном поле либо показать график и запросить интерпретацию данных.
Для визуального направления Liquid AI разработала собственный энкодер изображений. Ему требуется в три раза меньше вычислений, чем SigLIP2-энкодеру из предыдущих моделей LFM VL. При обработке видео энкодер совместно разбирает пары выбранных кадров, сокращая временную последовательность признаков перед следующим этапом обработки.
LFM3-VL-2B можно дообучать под специализированные визуальные задачи.
Голосовой ввод, синтез и анализ звука в LFM3-Audio-2B
LFM3-Audio-2B – аудиомодель, принимающая текст или аудио и отвечающая текстом, речью либо обоими форматами. Она рассчитана на локальную работу на ноутбуках и edge-устройствах и поддерживает распознавание, синтез и перевод речи для 18 языков.
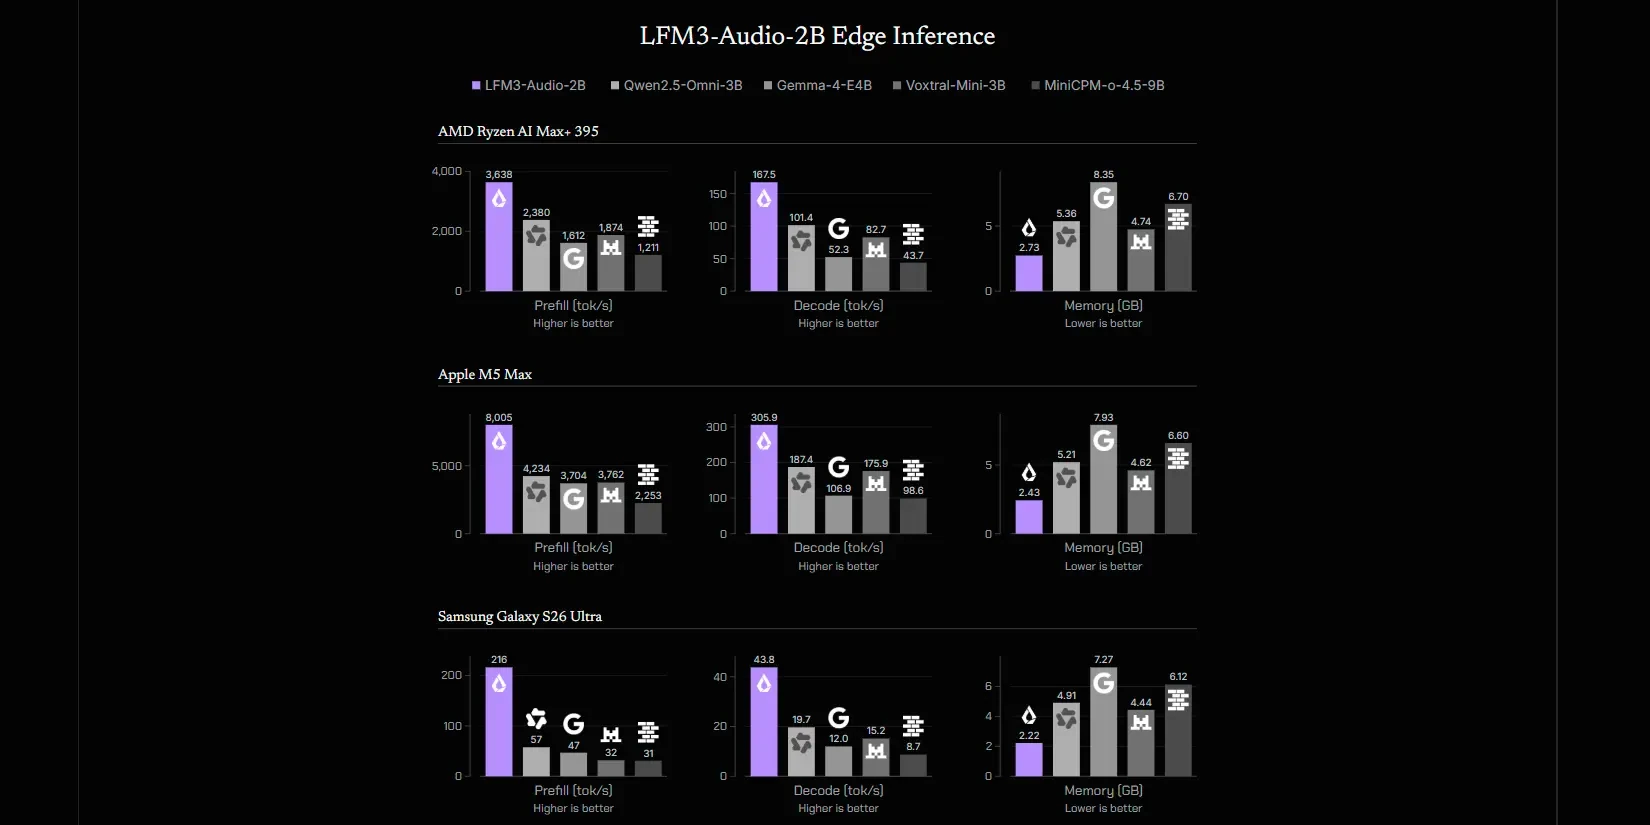
Один из сценариев использования – голосовой чат: пользователь задаёт вопрос вслух и получает потоковый ответ одновременно в текстовом и голосовом виде. В текстовом режиме модель также способна рассуждать перед ответом. Такой подход может быть полезен для локальных голосовых интерфейсов, где нежелательно постоянно отправлять аудио в облако.
Отдельно поддерживается понимание аудиозаписей и рассуждение о речи, звуках и событиях в них. Приложение может передать модели запись разговора или окружающих звуков, а затем задать вопрос по содержанию. Модель также умеет превращать устные запросы в вызовы инструментов для управления приложениями и устройствами, если нужные инструменты подключены разработчиком.
Аудиоэнкодер LFM3-Audio-2B полностью причинный, поэтому может обрабатывать сигнал с микрофона по мере его поступления. Время до первого токена от 50 мс. Для генерации речи используется LiquidCodec: на одном потоке Apple M4 Max он декодирует звук примерно в 87 раз быстрее реального времени.
Совместная работа с изображением, звуком и текстом в LFM3-Omni-2B
LFM3-Omni-2B объединяет зрение, аудио и язык в одной модели. Она может принять изображение и голосовой вопрос к нему, а затем выдать текстовый, голосовой или комбинированный ответ. Этим она отличается от отдельных текстовой, визуальной и аудиомоделей семейства.
Модель способна анализировать видео вместе с синхронизированной аудиодорожкой. Это позволяет задавать вопросы, где важны и происходящее в кадре, и то, что было сказано или услышано. Например, можно обработать ролик и спросить о действии на экране с учётом реплики участника.
LFM3-Omni-2B поддерживает мультимодальные вызовы инструментов: визуальный контекст соединяется с голосовой инструкцией, а результатом становится структурированный вызов функции. ИИ может сделать помощника, объясняющего рукописную математическую задачу по фотографии и голосовому вопросу, а также интерфейсов для навигации по цифровым приложениям.
Модель содержит около 2,2 млрд параметров и проектировалась для работы в средах с ограниченными ресурсами. Нейросеть можно применить в обучении, повседневных голосовых помощниках, автомобильных интерфейсах и робототехнике.
Быстрые структурированные решения в d1-2B и d1-Omni-2B
В линейке есть две decision-модели: d1-2B для текста и изображений, а также d1-Omni-2B, дополнительно принимающая аудио. В отличие от обычной диалоговой модели, они не должны формировать развёрнутый ответ на каждый запрос. Вместо этого им передают ситуацию и набор вопросов, а модели выдают решения с калиброванной вероятностью за один проход.
Такой формат подходит для поточной обработки однотипных объектов: обращений в поддержку, счетов, экранов приложений, фотографий, голосовых заметок или кадров с камеры. Например, можно передать счёт и попросить извлечь дату, сумму и другие поля, отдельно указав, что нужно сообщить об отсутствии данных.
Модели умеют отвечать на несколько вопросов по одному входному объекту за один проход. Для них есть несколько типов ответа:
- Point – поиск объекта и выделение его рамкой, включая подсчёт всех совпадений.
- Read – извлечение текста, чисел и дат с точным фрагментом источника.
- Estimate – возврат числового значения вместе с вероятным диапазоном.
- Pick – выбор всех подходящих вариантов с указанием вероятности для каждого.
d1-Omni-2B принимает те же вопросы голосом, поэтому голосовой запрос можно использовать для маршрутизации или проверки обращения. Liquid AI также поддерживает распознавание повседневных звуков и определение языка речи. Для аудио следует выбирать d1-Omni-2B, а для текста и изображений – d1-2B.
Локальное развёртывание и дообучение
Все модели первого релиза относятся к классу около 2 млрд параметров и позиционируются как основа для специализации. Каждую из них можно дообучить на одной GPU с использованием собственных данных. Это особенно полезно при работе с внутренней терминологией, специализированными документами или редкими типами изображений.
Открытые веса позволяют скачать модели, адаптировать их и развернуть в нужной среде. Поддерживаются Hugging Face, Liquid AI API и Playground, а также нативная поддержка llama.cpp, MLX и vLLM. Среди упомянутых аппаратных платформ – Apple, AMD, NVIDIA, Qualcomm и Intel через OpenVINO.
LFM3-VL-2B обучили для инспекции лопастей ветрогенераторов по фотографиям с дронов. После короткого дообучения на публичном наборе изображений модель использовалась для классификации дефектов, их локализации и формирования краткого заключения по снимку.
LFM3-VL-2B также адаптировали для управления роботизированной рукой, визуально-языковой навигации и предсказания действий робота. Это показывает возможности архитектуры после дополнительного обучения, а не готовую функцию модели «из коробки».
Условия использования LFM3
Весовые коэффициенты базовых и постобученных моделей доступны через Hugging Face. Также Liquid AI предлагает Playground и API для работы с моделями. Для локального запуска заявлена поддержка llama.cpp, MLX и vLLM.
Стоимость облачного API Liquid Console рассчитывается за 1 млн токенов. Новые аккаунты получают стартовый бесплатный баланс $2.
| Тип токенов | LFM3-1.7B | LFM3-VL-2B | LFM3-Audio-2B / LFM3-Omni-2B |
|---|---|---|---|
| Входные текстовые токены | $0.08 за 1 млн | $0.10 за 1 млн | $0.10 за 1 млн |
| Входные визуальные токены | – | $0.10 за 1 млн | $0.10 за 1 млн |
| Кэшированный контекст | $0.02 за 1 млн | $0.02 за 1 млн | $0.02 за 1 млн |
| Выходные текстовые токены | $0.20 за 1 млн | $0.50 за 1 млн | $1.00 за 1 млн |
| Входные аудиотокены | – | – | $2.00 за 1 млн |
| Выходные аудиотокены | – | – | $10.00 за 1 млн |
Веса моделей доступны для локального запуска. Условия использования зависят от годового дохода организации в соответствии с LFM Open License v1.0.
Часто задаваемые вопросы
Что такое LFM3?
LFM3 – это семейство открытых по весам моделей Liquid AI для обработки текста, изображений, аудио, видео и структурированных решений. В линейку входят компактные модели примерно на 2 млрд параметров, рассчитанные на локальный запуск, дообучение и встраивание в приложения. Это не готовый чат-бот для конечного пользователя, а набор моделей для разработчиков.
Для чего нужен LFM3?
LFM3 нужен для создания локальных ИИ-функций в продуктах: агентов, голосовых интерфейсов, систем анализа документов, фото, видео и аудиозаписей. Модели можно применять для обработки писем, работы с календарём, распознавания данных в документах, поддержки, инспекции изображений и робототехнических задач. Конкретный сценарий зависит от выбранной модели и настроенной разработчиком интеграции.
Кому подойдет LFM3?
LFM3 подойдет разработчикам и командам, которым нужно развернуть модель рядом с приложением или адаптировать её под узкую задачу. Семейство может быть полезно при создании локальных агентов, мультимодальных приложений, голосовых помощников и решений для работы со специализированными данными. Для обычного пользователя без технической настройки это не самостоятельный потребительский сервис.
Какие возможности LFM3 есть для работы с текстом?
Текстовая LFM3-1.7B умеет следовать инструкциям, работать с вызовами инструментов и обрабатывать длинный контекст до 256 тыс. токенов. Её можно использовать в агентских окружениях для задач вроде сортировки писем, поиска информации или управления календарём. При этом подключение инструментов, сервисов и правил доступа остается задачей разработчика.
Может ли LFM3 анализировать изображения и видео?
Да, для этого предназначена модель LFM3-VL-2B. Она принимает изображения и видео, отвечает на вопросы по их содержанию и может применяться для OCR, анализа документов, диаграмм, интерфейсов и пространственных отношений. Модель также допускает дообучение для узких визуальных задач.
Как LFM3 работает с голосом и аудио?
LFM3-Audio-2B принимает текст или аудио и может выдавать текстовый, голосовой либо комбинированный ответ. Поддерживаются распознавание, синтез и перевод речи для 18 языков, а также понимание речи, звуков и событий в аудиозаписях. Модель рассчитана на локальную обработку потока с микрофона и может превращать голосовые команды в вызовы подключенных инструментов.
Что умеет омнимодальная модель LFM3-Omni-2B?
LFM3-Omni-2B объединяет работу с изображениями, аудио и текстом в одной модели. Например, ей можно передать картинку и голосовой вопрос, а в ответ получить текст, речь или оба формата. Она также способна анализировать видео вместе с аудиодорожкой и формировать мультимодальные вызовы инструментов.
Что делают decision-модели d1-2B и d1-Omni-2B?
Decision-модели предназначены для быстрых структурированных решений по входным данным, а не для развернутого диалога. Они могут извлекать поля из счетов, находить объекты на изображении, считывать текст и даты, выбирать подходящие варианты и указывать вероятность результата. d1-2B работает с текстом и изображениями, а d1-Omni-2B дополнительно принимает аудио и голосовые вопросы.
Как пользоваться LFM3?
Для начала нужно выбрать модель под тип данных и задачу: текстовую, визуальную, аудио-, омнимодальную или decision-модель. Веса доступны на Hugging Face, также упоминаются Playground и Liquid AI API; заявлена поддержка llama.cpp, MLX и vLLM. Затем модель можно развернуть локально или встроить в приложение, а для специальных задач – дообучить на собственных данных.
Можно ли запустить LFM3 локально и дообучить под свою задачу?
Да, локальное развёртывание – одно из направлений LFM3. Liquid AI указывает, что модели можно дообучать на собственных данных на одной GPU, а открытые веса позволяют адаптировать их под нужную среду. Также есть поддержка платформ Apple, AMD, NVIDIA, Qualcomm и Intel через OpenVINO.
Есть ли бесплатный тариф LFM3?
Веса базовых и постобученных моделей доступны на Hugging Face.
Сколько стоит LFM3?
Стоимость облачного API Liquid Console рассчитывается за 1 млн токенов.
Какие ограничения и минусы стоит учитывать?
LFM3 требует технической настройки: для агентских сценариев нужно самостоятельно подключать инструменты, сервисы и правила доступа.
Чем LFM3 отличается от похожих ИИ-инструментов?
Особенность LFM3 – набор отдельных компактных моделей для текста, зрения, аудио, мультимодальных задач и структурированных решений, а не одна универсальная модель для всех сценариев. Семейство ориентировано на открытые веса, локальное развертывание и дообучение под конкретную задачу.