Что такое GLM-5.3-UNCENSORED-EXL3-3.0bpw
GLM-5.3-UNCENSORED-EXL3-3.0bpw – это локальная квантизированная версия большой языковой модели GLM-5.3, предназначенная для генерации текста и работы в качестве интеллектуального агента. Модель основана на dealignai/GLM-5.3-UNCENSORED-FP8, которая, в свою очередь, является модифицированной на уровне весов версией официальной GLM-5.3 без дополнительного fine-tuning.
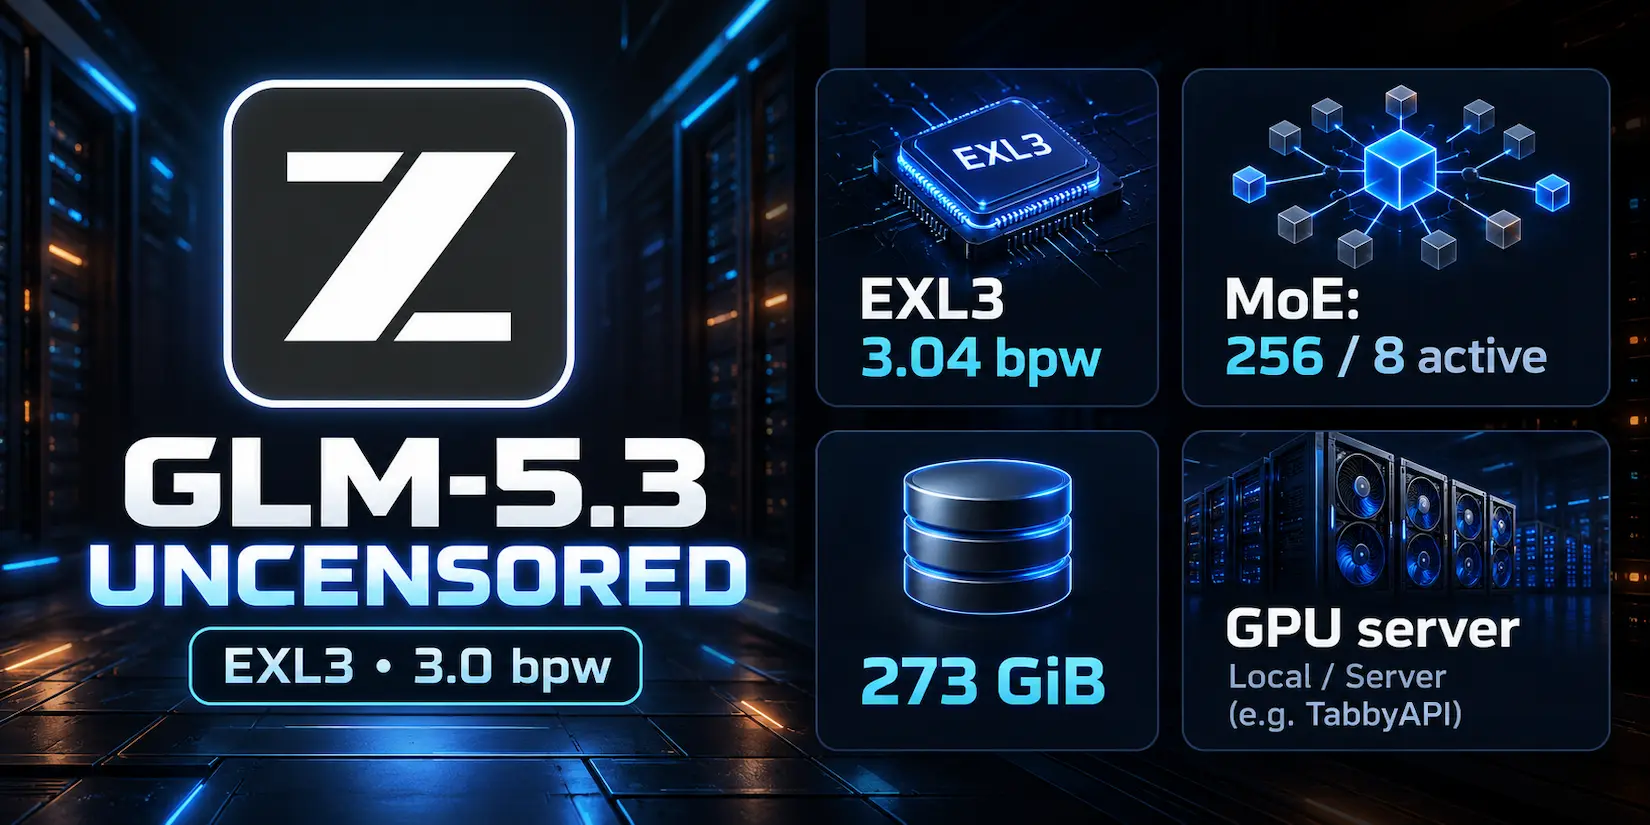
Важная особенность этой версии заключается в сочетании очень крупной архитектуры GLM-5.3 с агрессивной EXL3-квантизацией примерно до 3,04 бит на параметр, благодаря чему модель можно использовать локально на многопроцессорных GPU-системах.
Модель предназначена для широкого спектра задач, связанных с пониманием и генерацией естественного языка, включая диалог, анализ информации, написание текстов, обработку инструкций и решение сложных многоэтапных задач. За счёт архитектуры GLM-5.3 она ориентирована не только на короткие ответы, но и на выполнение продолжительных задач, в которых требуется сохранять контекст, планировать действия и последовательно работать над результатом.
Архитектурно это MoE-модель с 753 млрд общих параметров, 256 маршрутизируемыми экспертами, из которых для каждого токена активируются восемь, а также одним общим экспертом. Модель содержит 78 основных слоёв и дополнительный MTP-слой, который может использоваться для speculative decoding и ускорения генерации.
Тестировалась сборка в TabbyAPI на конфигурации из восьми NVIDIA A100 с 40 ГБ памяти на каждой видеокарте, распределяя слои между GPU. В проверке использовался общий кэш на 98 тысяч токенов и MTP-черновики.
Документация об изменениях весов находится в файле
CRACK_SURGERY.json
, скопированном из исходного репозитория. Автор EXL3-сборки отдельно указывает, что не аффилирован ни с dealignai, ни с Z.ai.
Файлы модели занимают около 273 GiB, поэтому это не компактный вариант для обычного ноутбука. Сборка прежде всего рассчитана на разработчиков и специалистов, которые умеют разворачивать крупные языковые модели на собственных GPU-серверах.
Ключевые возможности GLM-5.3-UNCENSORED-EXL3-3.0bpw
EXL3-квантование модели GLM-5.3-UNCENSORED
Модель представляет собой EXL3-квантованную сборку исходного FP8-чекпойнта. Квантование уменьшает точность хранения отдельных весов по сравнению с исходной версией, причем параметры выбраны не одинаково для всех компонентов модели.
Сборка конвертировалась через ExLlamaV3 на коммите
d3739fd
, используя калибровку по умолчанию: 250 строк по 2048 токенов. В результате разработчик получает конкретную EXL3-версию со средней битностью 3,04 bpw вместо исходного FP8-чекпойнта.
Экономия на формате не делает модель небольшой: размер файлов составляет 273 GiB. Поэтому квантование здесь следует рассматривать прежде всего как способ адаптировать очень крупную модель под совместимую серверную инфраструктуру.
Например, при развертывании через TabbyAPI можно использовать автоматическое распределение слоев по GPU с параметром
gpu_split_auto
. Именно так запускалась модель во время тестирования на восьми A100 по 40 ГБ.
Mixture-of-Experts-архитектура с маршрутизируемыми экспертами
GLM-5.3-UNCENSORED-EXL3-3.0bpw построена на архитектуре Mixture of Experts, или MoE. В ней включено 256 маршрутизируемых экспертов, но одновременно работают восемь. Дополнительно используется один общий эксперт.
Среди других характеристик есть MLA-внимание с разреженным индексатором DSA, 78 основных слоев и один MTP-слой. Эти параметры полезны при оценке устройства модели и планировании ее запуска.
Число в 753 млрд параметров не означает, что при обработке каждого фрагмента текста все параметры задействуются одинаково.
MTP-слой для speculative decoding
В сборку добавлен MTP-слой, предназначенный для предсказания следующего токена. Его можно использовать как черновую модель для speculative decoding в TabbyAPI, указав параметр
draft_mode: mtp
.
В такой конфигурации эксперты MTP-слоя работают с 4 bpw, а механизм внимания и общий эксперт – с 6 bpw. Спекулятивное декодирование применяют в сценариях, где основной модели помогают предварительные предположения о следующих токенах.
MTP-слой уже включен в репозиторий, поэтому для этого режима не нужно отдельно искать стороннюю draft-модель.
Вызов инструментов и обработка аргументов
Модель умеет формировать аргументы для инструментов, но есть важная особенность их представления. Значения записываются как сырой текст, например:
<arg_value>9523456873</arg_value>
.
Проблема может возникнуть, если промежуточный парсер автоматически преобразует строку, внешне похожую на число, в числовой тип. Это критично для идентификаторов, номеров заказов, артикулов, почтовых индексов и других значений, которые должны оставаться строками.
Приводится пример с парсером
glm4_5
в TabbyAPI на коммите
be74bf0
. Парсер JSON-декодировал каждое значение без сверки со схемой инструмента. В результате номера заказов, товаров или почтовые индексы передавались как числа вместо строк.
В тесте tau2-bench retail такая ошибка привела примерно к 70% неудачных вызовов инструментов. Для агентных сценариев необходимо скорректировать обработку аргументов: параметры с типом
string
, указанным в схеме, должны сохраняться в исходном текстовом виде.
Условия использования GLM-5.3-UNCENSORED-EXL3-3.0bpw
Это бесплатный проект.
Часто задаваемые вопросы
Что такое GLM-5.3-UNCENSORED-EXL3-3.0bpw?
GLM-5.3-UNCENSORED-EXL3-3.0bpw – это квантованная EXL3-сборка языковой модели, размещенная в виде репозитория на Hugging Face. Это не готовый веб-чат, а модель для локального или серверного запуска через совместимые инструменты, включая TabbyAPI. Сборка основана на версии GLM-5.3-UNCENSORED-FP8 и имеет среднюю битность весов 3,04 bpw.
Для чего нужен GLM-5.3-UNCENSORED-EXL3-3.0bpw?
Модель предназначена для разработчиков, которым нужно развернуть крупную языковую модель на собственной GPU-инфраструктуре в формате EXL3. Она может использоваться в сценариях генерации текста, агентных задачах и вызовах инструментов при корректной обработке аргументов. Квантование позволяет работать с версией модели, занимающей меньше места, чем исходный FP8-чекпойнт, хотя размер файлов все равно составляет 273 GiB.
Кому подойдет GLM-5.3-UNCENSORED-EXL3-3.0bpw?
GLM-5.3-UNCENSORED-EXL3-3.0bpw подойдет специалистам, которые умеют запускать большие модели на нескольких видеокартах и настраивать совместимые рантаймы. Проверялась сборка на сервере с восемью NVIDIA A100 по 40 ГБ, распределяя слои между GPU. Для обычного ноутбука или пользователя, которому нужен готовый чат-интерфейс, эта модель не рассчитана.
Какие возможности GLM-5.3-UNCENSORED-EXL3-3.0bpw заявлены в описании?
Сборка использует MoE-архитектуру с 256 маршрутизируемыми экспертами, из которых одновременно активны восемь, а также с одним общим экспертом. В модели включены 78 основных слоев, MLA-внимание с разреженным индексатором DSA и MTP-слой. MTP можно задействовать как черновую модель для speculative decoding в TabbyAPI.
Как пользоваться GLM-5.3-UNCENSORED-EXL3-3.0bpw?
Для запуска понадобится совместимый инструмент для EXL3-моделей, например TabbyAPI, и собственная GPU-инфраструктура. В тесте использовалось автоматическое распределение слоев между видеокартами через параметр
gpu_split_auto
. Для speculative decoding можно включить MTP-черновики с параметром
draft_mode: mtp
.
Можно ли использовать модель для вызова инструментов?
Модель умеет формировать аргументы для инструментов, но разработчику важно правильно настроить их разбор. Значения, которые выглядят как числа, могут быть строковыми идентификаторами, например номером заказа или почтовым индексом. Если схема инструмента задает тип
string
, такие значения нужно сохранять как исходный текст, а не автоматически преобразовывать в число.
Сколько стоит GLM-5.3-UNCENSORED-EXL3-3.0bpw?
GLM-5.3-UNCENSORED-EXL3-3.0bpw бесплатен.
Какие ограничения есть у модели?
Главное ограничение – высокий объем модели: файлы занимают 273 GiB, поэтому для запуска нужна серьезная серверная конфигурация с несколькими GPU.
Чем эта EXL3-сборка отличается от исходной FP8-версии?
Основное отличие – формат хранения весов: в этой версии используется EXL3-квантование со средней битностью 3,04 bpw вместо исходного FP8-чекпойнта. Разные части модели квантованы с разной точностью: маршрутизируемые эксперты используют 3 bpw, плотные MLP-блоки – 4 bpw, а внимание и общие эксперты – 5 bpw.