Что такое Gemini 3.8 Flash TTS
Gemini 3.8 Flash TTS – модель Google для преобразования текста в речь через Gemini API. Она создаёт аудио с упором на студийное качество, естественные интонации, эмоциональную выразительность и стабильное звучание голоса в длинных репликах. Модель рассчитана на задачи, где простого ровного синтетического голоса уже недостаточно.
Ключевая особенность Gemini 3.8 Flash TTS – управление речевой подачей через структурированные метаданные и отдельные голосовые события прямо в тексте. Еще одной особенностью архитектуры является экстремально низкая задержка до генерации первого аудиотокена, благодаря чему модель идеально подходит для создания интерактивных голосовых агентов реального времени. В процессе работы нейросеть проводит глубокий интонационный анализ текста, точно расставляя логические ударения в омографах на основе соседних слов и регулируя длительность пауз в зависимости от знаков препинания. Модель способна имитировать живое человеческое дыхание, добавляя естественные микро-вдохи перед длинными фразами, а также гибко менять эмоциональный регистр от испуганного шепота до радостного энтузиазма.
Говорящего и стиль реплики можно указать через
speech_metadata
, а короткие паузы или вокализации – отметить тегами вроде
<laugh>
,
<sigh>
и
<short pause>
.
Такой подход отделяет расшифровку от режиссёрских указаний: модель не должна произносить инструкцию вслух. Это особенно полезно для диалогов, аудиокниг, игровых реплик, голосовых ассистентов и других сценариев с выразительной озвучкой.
Модель самостоятельно определяет язык входного текста и поддерживает более 130 языков. Также поддерживается работа с региональными акцентами и диалектами меньшинств, однако полный список доступных языков, акцентов и голосов в предоставленном описании не приведён.
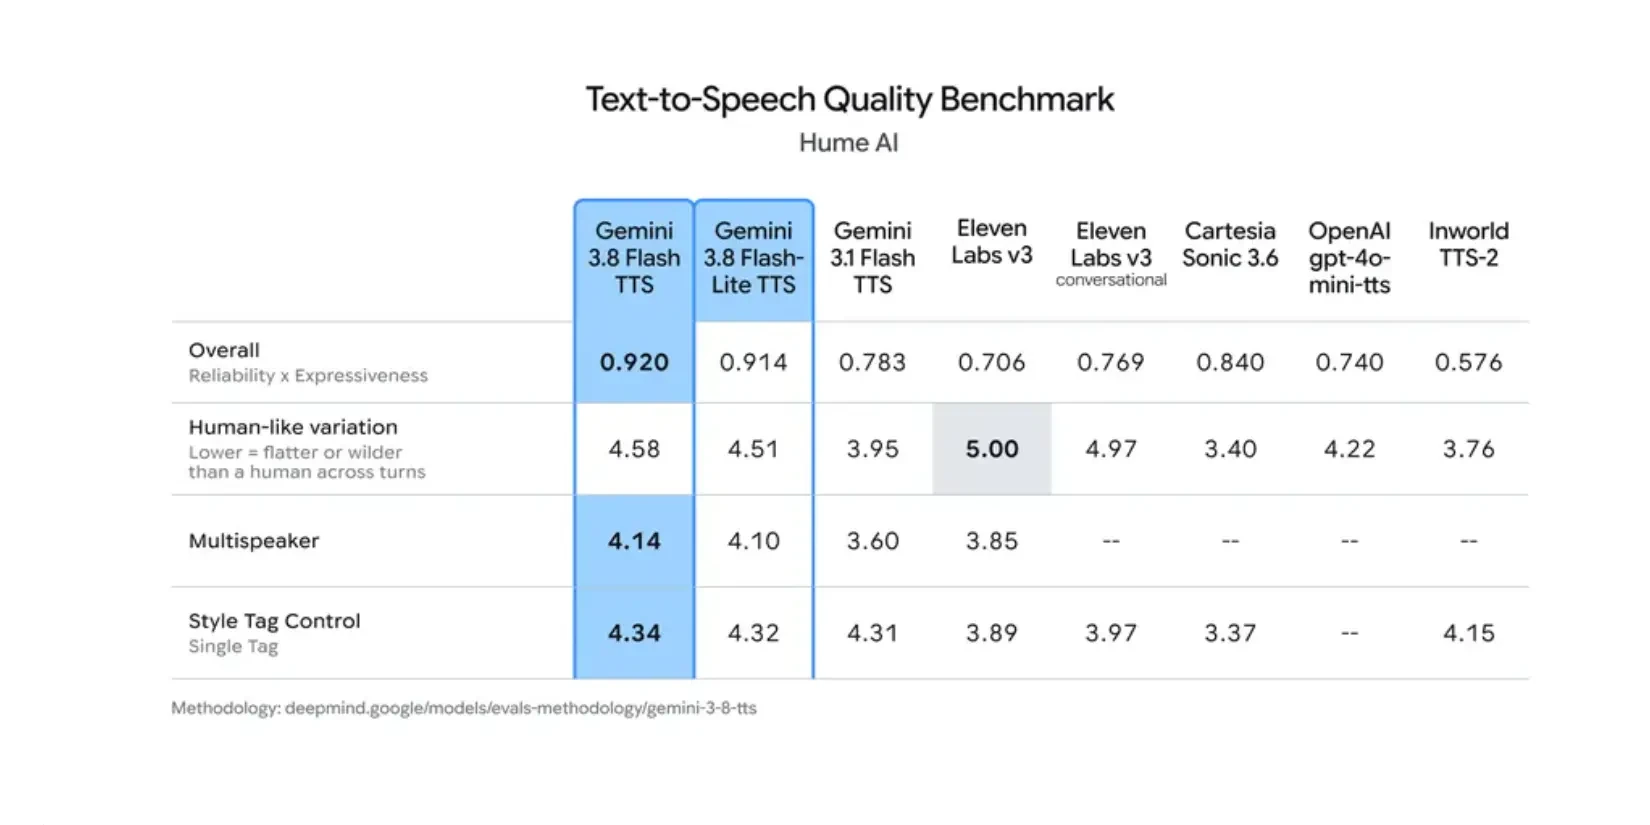
Сервис ориентирован прежде всего на разработчиков, которые подключают синтез речи через Gemini API, а также на пользователей Google AI Studio. В интерактивной среде можно создавать и реплицировать голоса, а затем применять подготовленные профили в запросах на генерацию аудио.
Gemini 3.8 Flash TTS может быть полезна для озвучки обучающих материалов, видеороликов, подкастов, аудиокниг, диалоговых сценариев, персонажей игр и голосовых интерфейсов. Особенно модель интересна проектам, где важно сохранить единый голос и манеру речи на протяжении большого количества реплик.
Выразительная озвучка и управление стилем речи
Gemini 3.8 Flash TTS умеет превращать обычный текст в речь с естественной интонацией, темпом, паузами и эмоциональными оттенками, поэтому результат может звучать скорее как профессиональная актерская озвучка, чем как стандартный синтезатор речи. В запросе можно указать, каким образом персонаж должен произносить конкретную реплику: например, спокойно, энергично, шепотом, взволнованно, дружелюбно, напряженно или с ощущением усталости.. Для продолжительных характеристик речи, например, спокойной, напряжённой или шёпотной манеры – используется поле
speech_metadata.style
.
Для кратковременных вокальных событий модель поддерживает специальные теги вроде
<laugh>
,
<sigh>
,
<cough>
,
<breath>
и
<short pause>
, позволяющие добавлять естественные реакции непосредственно в сценарий.
При этом постоянные характеристики исполнения, такие как шёпотная, напряжённая или спокойная манера, лучше задавать через speech_metadata.style, а не через тег в тексте.
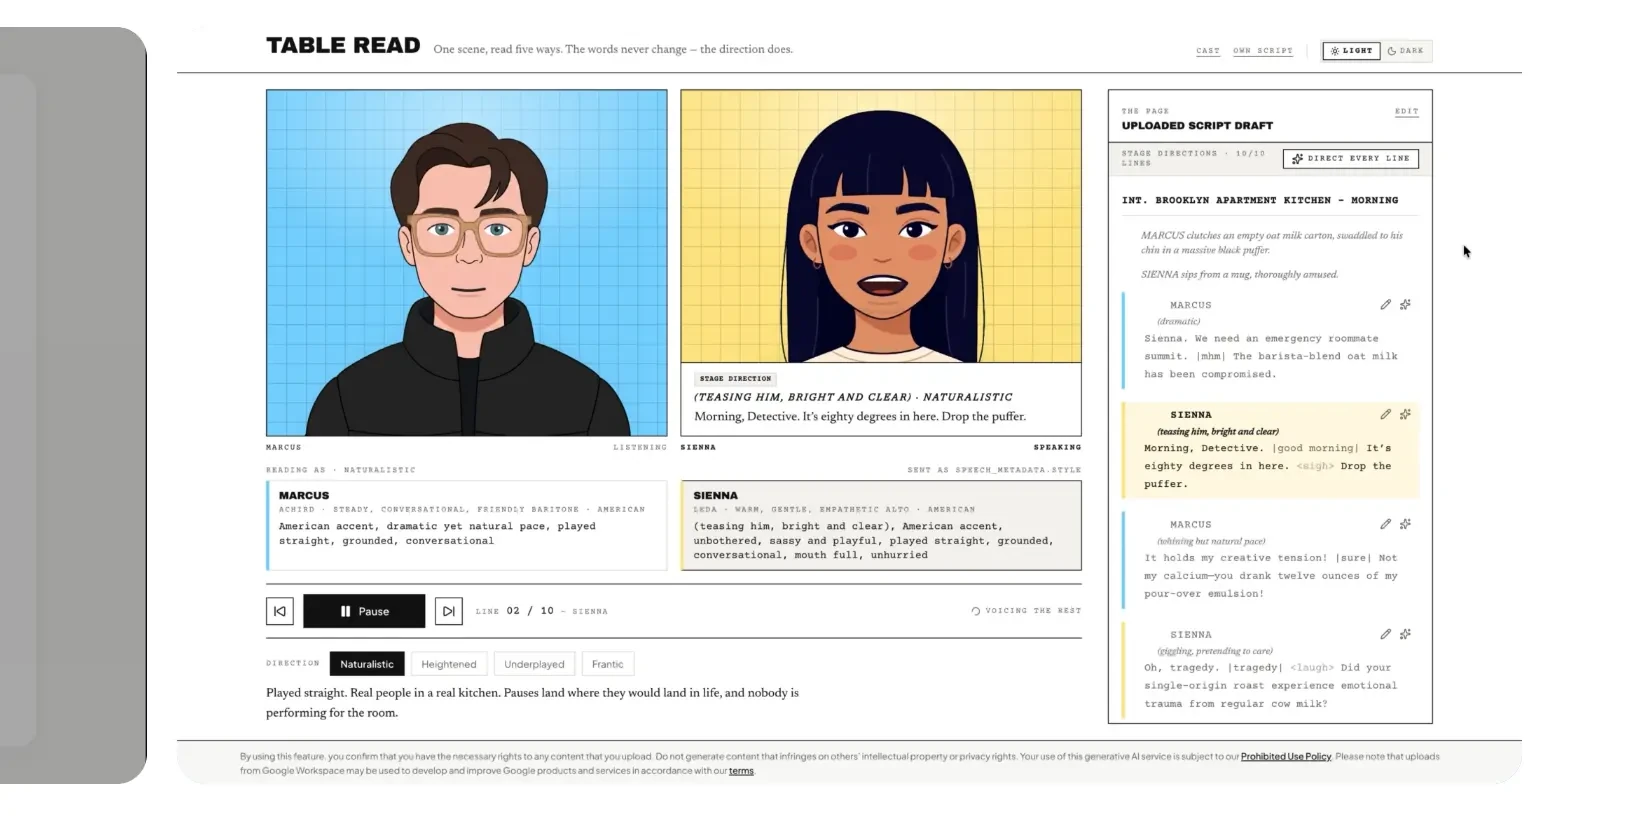
За счёт метаданных инструкции не смешиваются с текстом, который должен прозвучать в аудио. Если добавить в расшифровку фразу вроде «Say cheerfully: Hello!», модель может озвучить её полностью. Поэтому в Gemini 3.8 TTS указания по подаче рекомендуется выносить в структурированные параметры запроса.
Практический запрос может включать текст реплики, а также параметры
speaker
и
style
. В GenerateContent API метаданные добавляют к каждой
part
, а в Interactions API для этой задачи используются аннотации типа
speech_metadata
.
speech_metadata.style
. Теги внутри текста лучше оставлять для коротких событий: вздохов, смеха, кашля, дыхания и пауз.
Например, фразу «Подожди… ты это слышал?» можно дополнить короткой паузой и вздохом, чтобы создать напряженную сцену вместо механического прочтения текста. Такой подход особенно полезен при создании аудиокниг, рекламных роликов, игровых диалогов, обучающих материалов и видеороликов, где эмоциональная подача непосредственно влияет на восприятие контента.
Стабильное звучание в длинных диалогах и повествовании
Gemini 3.8 Flash TTS рассчитан на длинные повествовательные материалы и старается сохранять идентичность голоса, тембр, громкость, интонационную манеру и акустическое окружение на протяжении продолжительных сцен. Это особенно важно для аудиокниг и подкастов, поскольку при генерации больших объемов речи у некоторых TTS-систем голос может постепенно начинать звучать иначе. Эта модель как решение для длинных нарративов с минимальным speaker drift, то есть с минимальным изменением характеристик голоса по мере продолжения записи.
Gemini 3.8 Flash TTS включает сохранение идентичности голоса, тембра, громкости и акустического тона помещения в продолжительных диалогах и многоминутных нарративах. Это стабильность без смещения голоса.
Для длинной озвучки это важное преимущество: при работе с отдельными короткими фрагментами голос нередко постепенно меняет тембр, громкость или манеру подачи. Gemini 3.8 Flash TTS предназначена для уменьшения такого эффекта в многоходовых сценариях.
Многочасовую аудиокнигу можно разделить на отдельные фрагменты для генерации, сохраняя одного и того же рассказчика на протяжении всего произведения. Аналогичный подход подходит для образовательного курса, где десятки уроков должны звучать так, будто их записал один и тот же диктор. Это делает модель пригодной для производства больших объемов контента, где ручная перезапись или постоянное редактирование готового аудио было бы слишком затратным.
В диалогах с несколькими участниками каждый ход должен содержать поле
speaker
внутри
speech_metadata
.
speaker
должно совпадать с одним из настроенных голосов. Для многостороннего диалога указывайте говорящего в каждой реплике, а не только в начале запроса.
Автоматическое определение языка и региональное произношение
Gemini 3.8 Flash TTS поддерживает 130 языков, поэтому его можно использовать для создания многоязычных аудиоверсий одного и того же контента. Модель способна работать не только с разными языками, но и с региональными вариантами произношения, что особенно важно для локализации рекламы, игр, обучающих платформ и видеоматериалов.
Например, один рекламный сценарий можно адаптировать для американской, мексиканской, европейской и других языковых аудиторий, выбирая соответствующие голосовые характеристики и региональные особенности. Для YouTube-видео это позволяет создавать версии ролика на нескольких языках без необходимости заново записывать диктора для каждой локализации.
В играх аналогичная технология может использоваться для выпуска персонажей на разных рынках с сохранением их индивидуального характера и эмоциональной манеры. Таким образом, TTS становится не просто инструментом преобразования текста в речь, а частью полноценного процесса международной локализации аудиоконтента.
Создание собственных голосов
Одной из ключевых возможностей Gemini 3.8 Flash TTS является Voice Design, позволяющий создавать совершенно новые голосовые персонажи по текстовому описанию без необходимости искать подходящий готовый голос.
Пользователь может описать желаемую персону естественным языком, например: «молодой энергичный ведущий научно-фантастического подкаста с мягким британским акцентом» или «низкий, немного хриплый голос пожилого детектива, говорящего медленно и уверенно».
Модель способна учитывать такие характеристики, как возрастное восприятие голоса, акцент, высота тона, тембр, характер и общая манера речи, а созданный голос можно использовать последовательно в разных материалах. Это позволяет сформировать целый набор персонажей для игры, мультфильма, аудиокниги или интерактивного приложения, сохраняя их индивидуальность между отдельными сценами.
Например, разработчик игры может создать отдельные голоса для капитана космического корабля, робота и инопланетного персонажа, а затем использовать их в различных диалогах. Google также предоставляет библиотеку из более чем 2000 готовых производственных голосов, а созданные пользователем голоса можно сохранять для последующего использования в проектах.
Озвучка персонажей для игр и интерактивных приложений
Модель подходит для создания персонажей, которые должны не просто произносить заранее записанные реплики, а демонстрировать различные эмоциональные состояния и индивидуальные особенности речи.
Разработчик может заранее создать голосовую персону персонажа, а затем передавать ей разные реплики с указанием того, как именно они должны быть сыграны в конкретной ситуации.
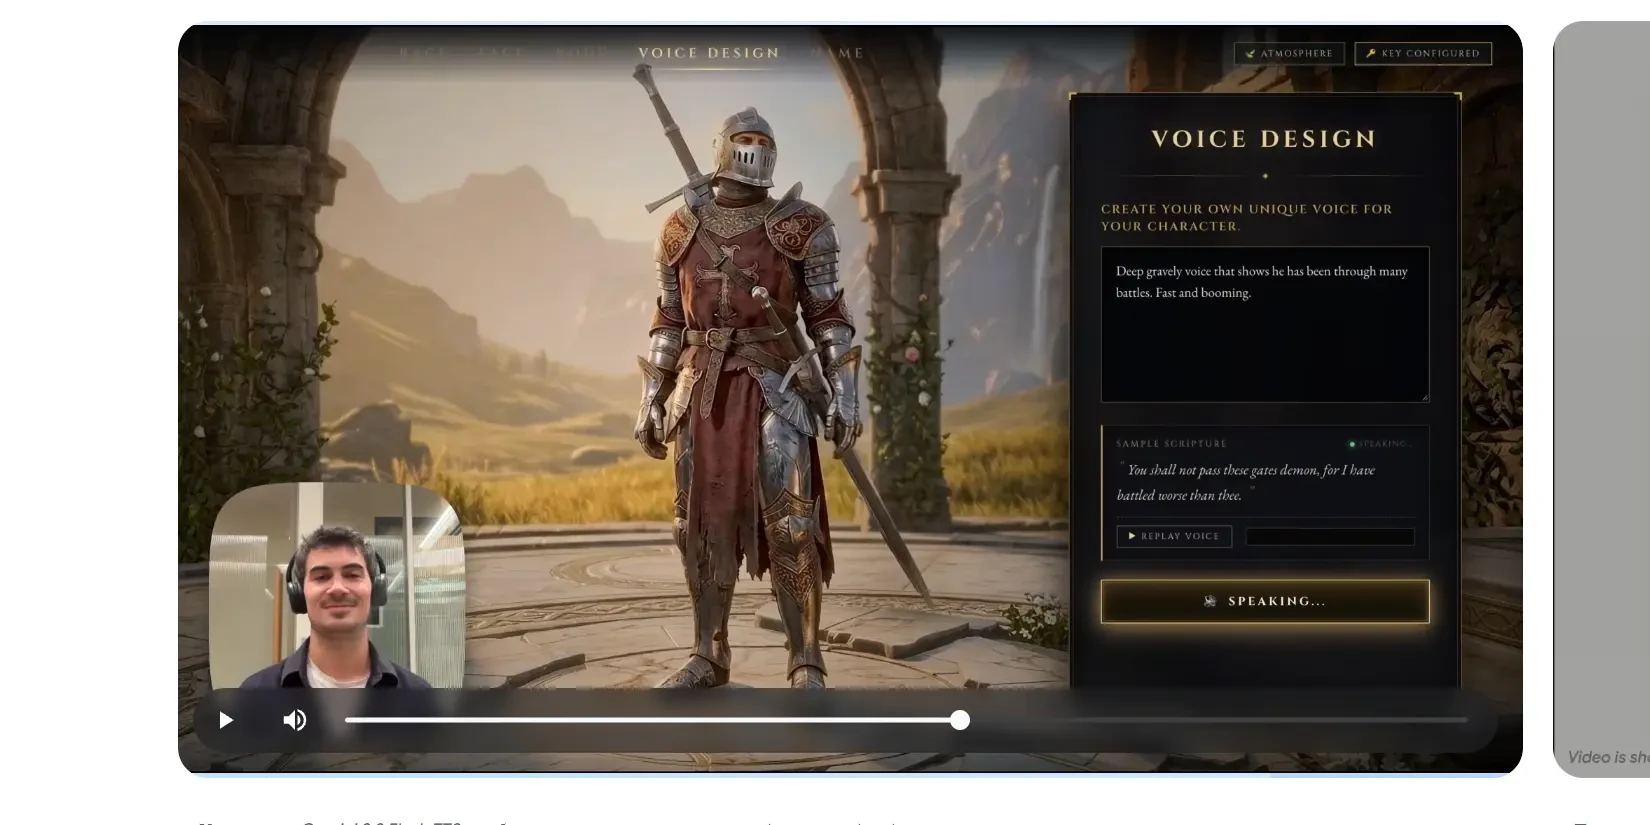
Например, один и тот же герой может спокойно объяснять игроку задание, испуганно реагировать на опасность, шепотом предупреждать о противнике или смеяться после победы. Использование вокальных реакций вроде вздоха, смеха, паузы или короткого междометия помогает сделать персонажей более живыми и приблизить диалоги к настоящему разговору.
Такой подход особенно интересен для RPG, визуальных новелл, интерактивных историй и виртуальных персонажей, поскольку количество возможных реплик там может быть очень большим. Вместо предварительной записи каждой вариации разработчик может генерировать большое количество реплик, сохраняя общий голосовой образ персонажа.
Условия использования Gemini 3.8 Flash TTS
Стоимость API зависит от выбранного тарифа. Цены указаны за 1 миллион токенов.
До 31 декабря 2026 года действует вводная акция Google со скидкой 50%. С 1 января 2027 года стоимость ввода и вывода вырастет в два раза.
| Тариф |
Ввод текста
до 31.12.2026 |
Вывод аудио
до 31.12.2026 |
Ввод текста
с 01.01.2027 |
Вывод аудио
с 01.01.2027 |
|---|---|---|---|---|
| Standard | $0.50 | $9.00 | $1.00 | $18.00 |
| Batch | $0.25 | $4.50 | $0.50 | $9.00 |
| Flex | $0.25 | $4.50 | $0.50 | $9.00 |
| Priority | $0.90 | $16.20 | $1.80 | $32.40 |
Генерация аудио использует примерно 25 токенов на секунду звука, или около 90 000 аудиотокенов на час. При текущей цене Standard один час готовой озвучки стоит примерно $0.81, не считая менее цента за входящий текст.
При фоновой пакетной обработке Batch стоимость часа озвучки снижается примерно до $0.40.
В Google AI Studio доступен Free Tier с бесплатным лимитом для тестирования. Он предусматривает ограничения на количество запросов в минуту и в день.
Часто задаваемые вопросы
Что такое Gemini 3.8 Flash TTS?
Gemini 3.8 Flash TTS – модель Google для преобразования текста в речь через Gemini API. Она создаёт аудио с естественной интонацией, эмоциональной подачей и стабильным звучанием голоса в длинных репликах и диалогах.
Для чего нужен Gemini 3.8 Flash TTS?
Сервис нужен для синтеза озвучки, когда важны не только разборчивость текста, но и манера речи, паузы, эмоции и постоянство голоса. Его можно применять для продолжительного повествования, многоходовых диалогов и серий аудиофрагментов с одним или несколькими настроенными голосами.
Кому подойдет Gemini 3.8 Flash TTS?
Gemini 3.8 Flash TTS подойдет разработчикам, которые подключают синтез речи через Gemini API, а также пользователям Google AI Studio. В первую очередь модель рассчитана на проекты, где требуется управлять голосом, стилем отдельных реплик и несколькими участниками диалога.
Какие возможности Gemini 3.8 Flash TTS доступны для управления речью?
Эмоции, стиль подачи, темп, паузы, интонацию и просодию, высоту тона, громкость, акцент и диалект, произношение, акцентирование слов, вокальные реакции, многоголосые диалоги и создание/репликацию голосов. Причем сильная сторона Gemini 3.8 Flash TTS заключается именно в сочетании этих параметров: можно создать голос персонажа, а затем для каждой отдельной реплики задавать, как именно этот голос должен ее сыграть.
Поддерживает ли модель длинные тексты и диалоги?
Модель поддерживает сохранение тембра, громкости, голосовой идентичности и акустического тона в продолжительных диалогах и многоминутном повествовании. В сценариях с несколькими персонажами для каждого хода нужно указывать поле
speaker
в
speech_metadata
.
Какие языки поддерживает Gemini 3.8 Flash TTS?
Gemini 3.8 Flash TTS автоматически определяет язык входного текста и поддерживает более 130 языков.
Можно ли использовать свои голоса или репликацию голоса?
Да. Gemini 3.8 Flash TTS поддерживает использование собственных голосов через Voice Design и репликацию голоса (Voice Replication) на основе аудиообразца.
Как пользоваться Gemini 3.8 Flash TTS через API?
В запрос передают текст реплики и при необходимости добавляют структурированные метаданные с именем говорящего и стилем речи. В GenerateContent API метаданные указывают для каждой
part
, а в Interactions API используют аннотации типа
speech_metadata
. Для диалога имя в поле
speaker
должно совпадать с одним из заранее настроенных голосов.
В каком формате возвращается аудио?
Для унарных запросов модель по умолчанию возвращает WAV-файл с типом
audio/wav
или
AUDIO_WAV
и стандартным RIFF-заголовком. При необходимости можно выбрать необработанные форматы
audio/l16
,
audio/mulaw
или
audio/alaw
. Если старый код вручную добавлял WAV-заголовок к PCM-данным, при переходе на эту модель это действие следует убрать.
Есть ли бесплатный тариф Gemini 3.8 Flash TTS?
Да. Gemini 3.8 Flash TTS имеет бесплатный тариф (Free Tier), то есть модель можно использовать без оплаты в пределах установленных квот. Платное использование тарифицируется отдельно по объёму токенов.
Сколько стоит Gemini 3.8 Flash TTS?
Платный Standard: $0,50 за 1 млн входных текстовых токенов до 31 декабря 2026 года. С 1 января 2027 года — $1 за 1 млн текстовых токенов.